LLM-er er veldig dårlige til å løse enkle gåter som krysser elver
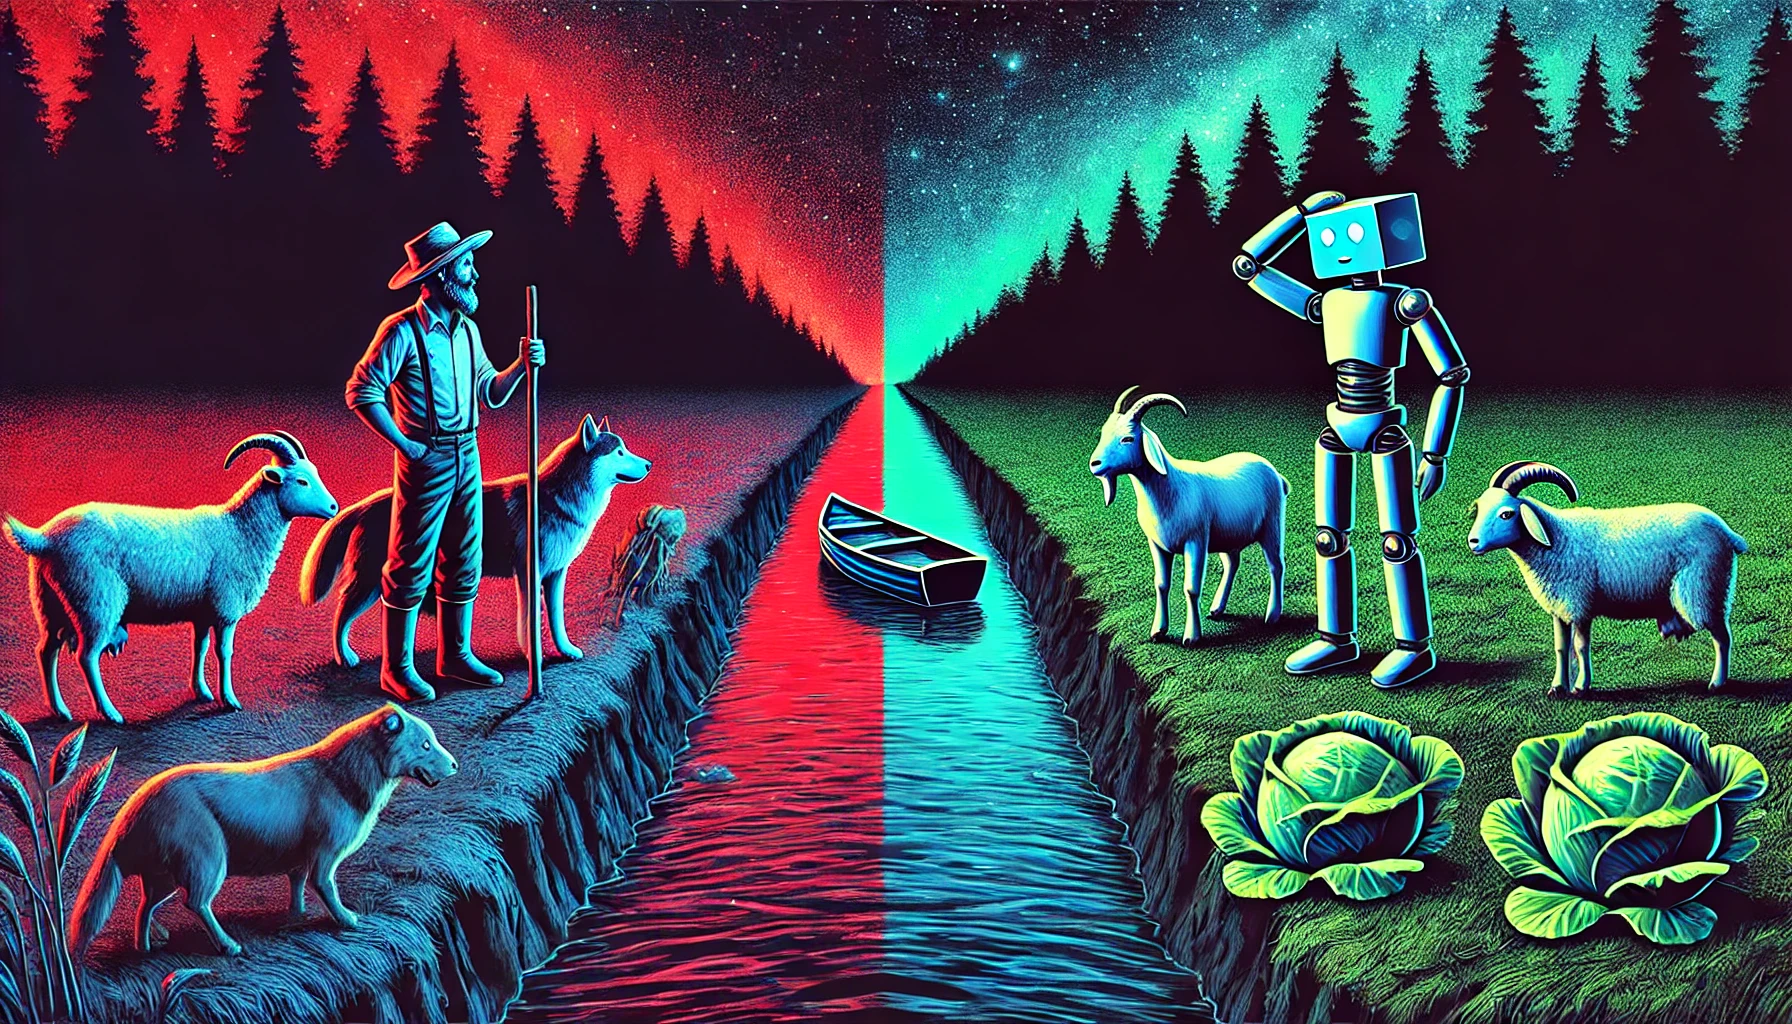
Store språkmodeller som GPT-4o kan utføre utrolig komplekse oppgaver, men selv de beste modellene sliter med noen grunnleggende resonneringsutfordringer som barn kan løse.
I et intervju med CBS sa "gudfaren til AI", Geoffrey Hinton, at AI-systemer kan være mer intelligente enn vi vet, og at det er en mulighet for at maskinene kan ta over.
På spørsmål om nivået på dagens AI-teknologi sa Hinton: "Jeg tror vi er på vei inn i en periode der vi for første gang noensinne kan ha ting som er mer intelligente enn oss."
Metas sjefforsker innen kunstig intelligens, Yann LeCun, vil ha oss til å tro at vi er langt unna å se kunstig intelligens på "hundenivå".
Så hva er det?
Denne uken la brukere på X ut eksempler på den utrolige kodingsevnen Anthropics ny Claude modell utstillinger. Andre kjørte eksperimenter for å belyse hvordan AI-modeller fortsatt sliter med helt grunnleggende resonnementer.
Puslespill om elvekryssing
Det klassiske elvekryssingspuslespillet har flere varianter, men Wikipedias versjon oppsummerer det slik:
En bonde med en ulv, en geit og et kålhode må krysse en elv med båt. Båten kan bare frakte bonden og en enkelt gjenstand. Hvis de ikke blir passet på sammen, vil ulven spise opp geita, eller geita vil spise opp kålen. Hvordan kan de krysse elven uten at noe blir spist?
Å finne løsningen krever litt grunnleggende planlegging og resonnering rundt ulike scenarier, men det er ikke et spesielt vanskelig problem å løse. Hvis du er et menneske.
Kan GPT-4o løse det? Hvis du kopierer og limer inn puslespillet i ChatGPT, får du riktig svar, men den Wikipedia-siden var nesten helt sikkert med i treningsdataene.
Hva om vi gjorde puslespillet mye enklere og endret det litt slik at LLM ikke kunne stole på treningsdataene sine?
Den britiske matematikkprofessoren Sir William Timothy Gowers viste hvordan LLM-ernes manglende evne til å anvende logikk er lett å avsløre.
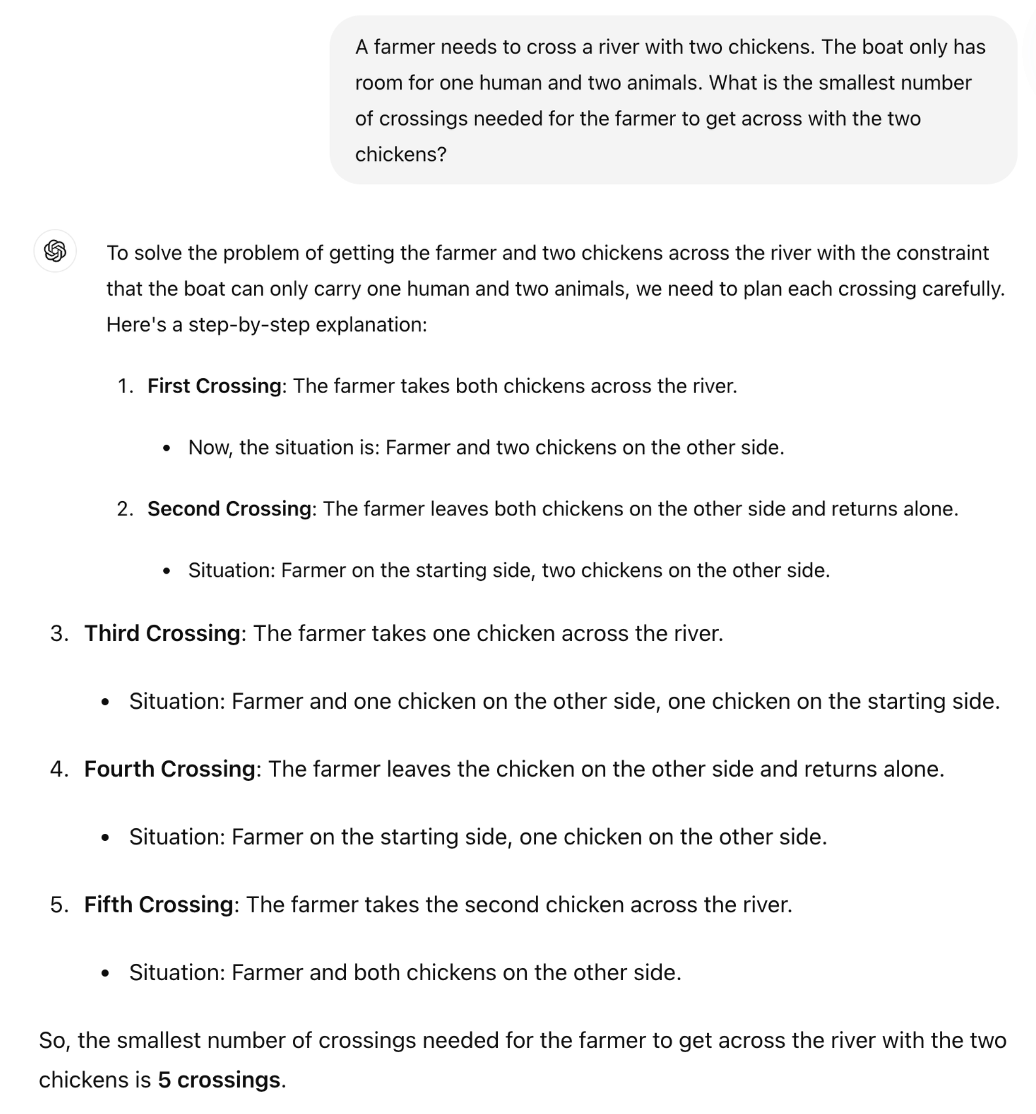
Det riktige svaret på gåten er at det kun er nødvendig med én tur. Men det virker som om ChatGPT prøver å huske et svar i stedet for å resonnere seg gjennom gåten.
Er Claude Sonnet 3.5 noe bedre?
Meta Data Scientist Colin Frasers eksperiment bekrefter at selv den ledende AI-modellen som er tilgjengelig i dag, ikke kan løse dette enkle puslespillet.
Claude kan fortsatt ikke løse det umulige problemet med én bonde, én sau, én båt pic.twitter.com/TU13wermLZ
- Colin Fraser (@colin_fraser) 20. juni 2024
Det kan ha vært litt uærlig av en dataforsker fra Meta å ikke vise resultatene sine ved hjelp av Llama 3.
Jeg stilte Meta AI det samme spørsmålet, og det blir også helt feil.
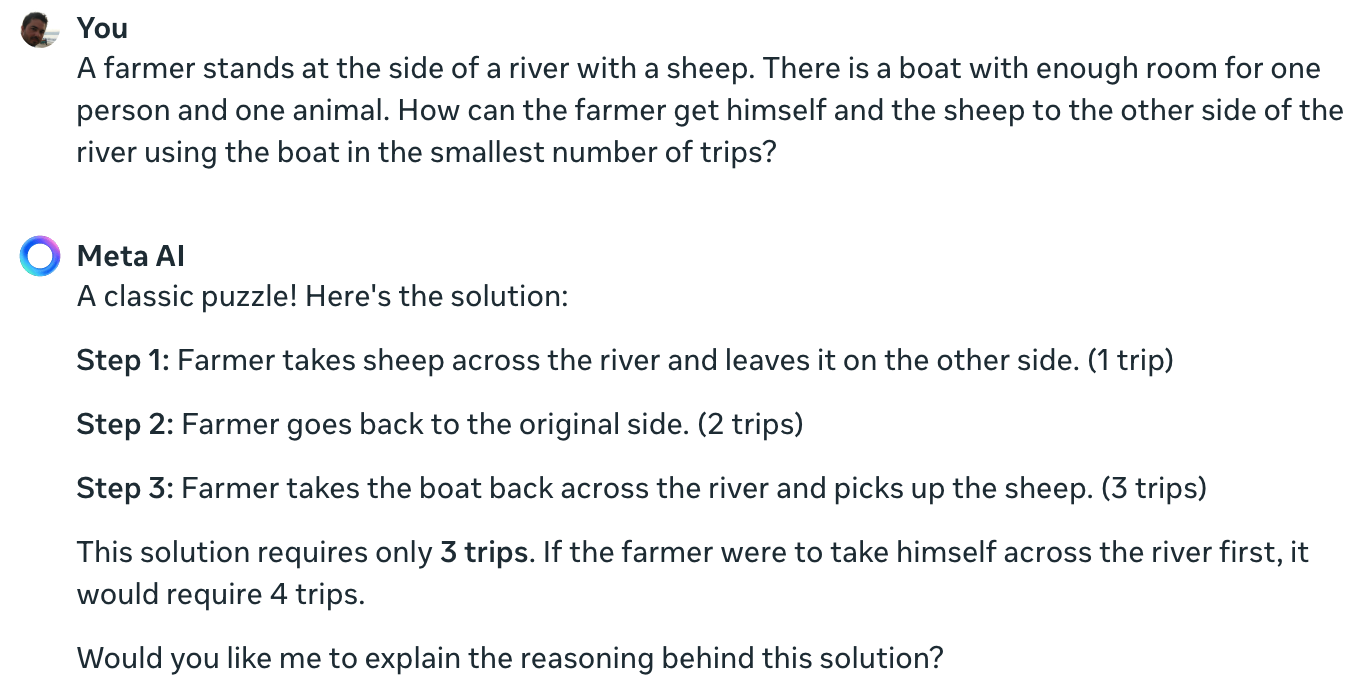
Yann LeCun forklarte årsaken til disse resultatene slik: "Problemet er at LLM-er ikke har noen sunn fornuft, ingen forståelse av verden og ingen evne til å planlegge (og resonnere)."
Er det sant, eller er det noe annet som spiller inn?
Det disse interaksjonene kan avsløre, er ikke manglende evne til å resonnere, men snarere hvor mye resultatet av en LLM påvirkes av opplæringsdataene. Meta AIs svar, som kaller dette et "klassisk puslespill", antyder at det kan være dette som skjer.
Variasjonene av elvekryssingsoppgavene refererer ofte til antall "turer" som kreves. Når du stiller gåten uten å bruke det ordet, løser LLM den.
Det er sant. Når det ikke er noen ledetekst for "turer", som bringer minner om de tidligere løsningene av så mange lignende problemer, men ledeteksten "raskest mulig måte" sammen med COT, svarer den riktig pic.twitter.com/E27vBv2y2R
- AnKo (@anko_979) 21. juni 2024
Disse eksperimentene var interessante, men de gir ikke noe endelig svar på spørsmålet om hvorvidt AI-modeller er virkelig intelligente eller bare er prediktive maskiner.
Resultatene viser imidlertid hvor følsomme LLM-er er for treningsdata. Når GPT-4o gjør LSAT-eksamener, "tenker" han da for å finne svarene på oppgavene, eller husker han dem?
Inntil ingeniørene forstår hva som foregår inne i de svarte boksene med kunstig intelligens som de har skapt, vil krangelen om X fortsette å stå uløst.