Дятел мог бы решить проблему мультимодальных галлюцинаций LLM.
Мультимодальные модели большого языка (MLLM), такие как GPT-4V, действительно хороши в анализе и описании изображений, но иногда они галлюцинируют и ошибаются. Новый подход под названием Woodpecker может это исправить.
Если вы попросите МЛМ описать фотографию, она, как правило, сможет выделить объекты и точно описать сцену. Но, как и в случае с ответами на текстовые подсказки, модель иногда делает предположения, основываясь на предметах или понятиях, которые часто встречаются вместе.
В результате МЛМ может описать фотографию витрины магазина и сказать, что на ней есть люди, хотя на самом деле их нет.
Работа по устранению галлюцинаций в текстовых ЛЛМ продолжается, но становится намного проще, когда модель подключена к интернету. ЛЛМ может генерировать текстовый ответ на запрос, проверять его на достоверность по соответствующим интернет-данным и при необходимости самокорректироваться.
Ученые из лаборатории YouTu Lab компании Tencent и Китайского университета науки и технологий взяли этот подход на вооружение и воплотили его в визуальном решении под названием Woodpecker.
Проще говоря, Woodpecker создает совокупность знаний на основе изображения, а затем LLM может использовать ее в качестве ссылки для корректировки первоначального описания, созданного MLLM.
Вот краткое описание того, как это работает:
- LLM типа GPT-3.5 Turbo анализирует описание, сгенерированное MLLM, и извлекает ключевые понятия, такие как объекты, количества и атрибуты. Например, в предложении "На мужчине надета черная шляпа" извлекаются объекты "мужчина" и "шляпа".
- Затем LLM предлагается сгенерировать вопросы, связанные с этими понятиями, например "Есть ли на изображении человек?" или "Во что одет человек?".
- Эти вопросы поступают в качестве подсказок в модель визуального ответа на вопросы (VQA). Grounding DINO выполняет обнаружение и подсчет объектов, а BLIP-2-FlanT5 VQA отвечает на вопросы, связанные с атрибутами, после анализа изображения.
- LLM объединяет ответы на вопросы в визуальную базу знаний об изображении.
- LLM использует этот справочный свод знаний, чтобы исправить любые галлюцинации в оригинальном описании MLLM и добавить детали, которые он упустил.
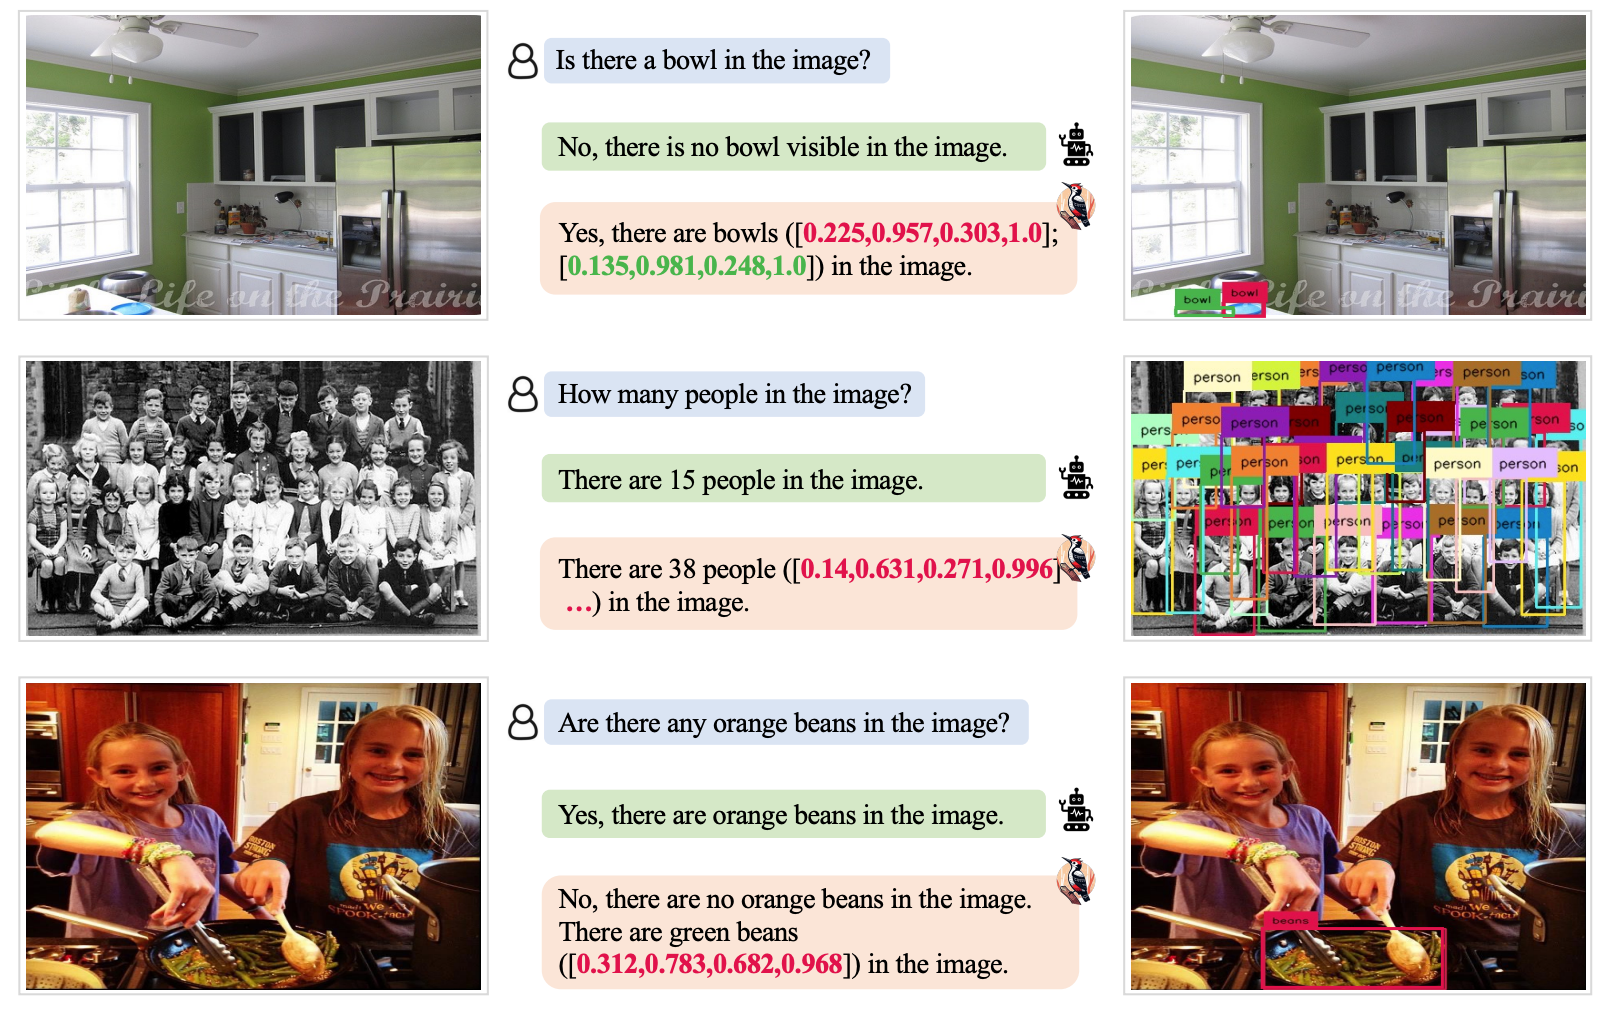
Исследователи назвали свой подход Woodpecker, ссылаясь на то, как эта птица собирает жуков с деревьев.
Результаты тестирования показали, что Woodpecker добился повышения точности на 30,66% для MiniGPT4 и на 24,33% для моделей mPLUG-Owl.
Общий характер моделей, требуемых в данном подходе, означает, что подход Woodpecker может быть легко интегрирован в различные MLLM.
Если OpenAI интегрирует Woodpecker в ChatGPT, то мы сможем увидеть заметное улучшение и без того впечатляющих визуальных характеристик. Уменьшение галлюцинаций MLLM также может улучшить автоматизированное принятие решений системами, использующими визуальные описания в качестве входных данных.