Технология Apple ReALM ‘видит’ изображение на экране лучше, чем GPT-4.

Инженеры Apple разработали систему искусственного интеллекта, которая решает сложные вопросы, связанные с экранными объектами и разговорами пользователей. Облегченная модель может стать идеальным решением для виртуальных помощников на устройствах.
Люди хорошо умеют определять отсылки в разговоре друг с другом. Когда мы используем такие термины, как "нижний" или "он", мы понимаем, что человек имеет в виду, исходя из контекста разговора и вещей, которые мы можем видеть.
Модели искусственного интеллекта сделать это гораздо сложнее. Мультимодальные LLM, такие как GPT-4, хорошо отвечают на вопросы об изображениях, но их обучение дорого и требует больших вычислительных затрат на обработку каждого запроса об изображении.
Инженеры Apple использовали другой подход в своей системе, названной ReALM (Reference Resolution As Language Modeling). Газета стоит прочитать, чтобы узнать больше подробностей о процессе разработки и тестирования.
ReALM использует LLM для обработки разговорных, экранных и фоновых объектов (сигналы тревоги, фоновая музыка), которые составляют взаимодействие пользователя с виртуальным агентом ИИ.
Вот пример того, как пользователь может взаимодействовать с агентом ИИ.
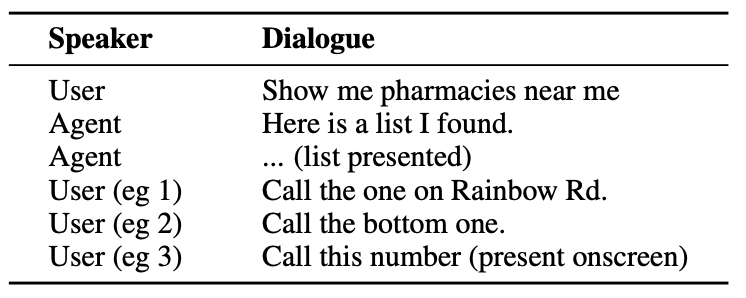
Агент должен понимать разговорные элементы, например то, что когда пользователь говорит "тот", он имеет в виду номер телефона аптеки.
Ему также необходимо понимать визуальный контекст, когда пользователь говорит "нижний", и в этом подход ReALM отличается от моделей типа GPT-4.
ReALM опирается на кодировщики, расположенные выше по течению, чтобы сначала разобрать экранные элементы и их положение. Затем ReALM реконструирует экран в чисто текстовом представлении по принципу "слева направо, сверху вниз".
Проще говоря, он использует естественный язык для краткого описания экрана пользователя.
Теперь, когда пользователь задает вопрос о чем-то на экране, языковая модель обрабатывает текстовое описание экрана, а не использует модель зрения для обработки изображения на экране.
Исследователи создали синтетические наборы данных разговорных, экранных и фоновых объектов и протестировали ReALM и другие модели, чтобы проверить их эффективность в разрешении ссылок в разговорных системах.
Меньшая версия ReALM (80M параметров) работает сопоставимо с GPT-4, а большая версия (3B параметров) существенно превосходит GPT-4.
ReALM - это миниатюрная модель по сравнению с GPT-4. Превосходное эталонное разрешение делает ее идеальным выбором для виртуального помощника, который может существовать на устройстве без ущерба для производительности.
ReALM не так хорошо справляется с более сложными изображениями или нюансами запросов пользователей, но он мог бы хорошо работать в качестве виртуального помощника в автомобиле или на устройстве. Представьте себе, что Siri могла бы "видеть" экран вашего iPhone и реагировать на ссылки на экранные элементы.
Компания Apple не сразу вышла на рынок, но последние разработки, такие как Модель MM1 и ReALM показывают, что многое происходит за закрытыми дверями.