Исследование Стэнфордского университета проверяет соответствие базовых моделей ИИ требованиям Закона ЕС об искусственном интеллекте.
Исследователи ИИ из Стэнфорда оценили соответствие 10 ведущих моделей ИИ предложенному ЕС закону об искусственном интеллекте и обнаружили большой разброс результатов, в целом неудовлетворительных.
Исследование Критики проанализировали 10 моделей ИИ на соответствие 12 критериям, изложенным в законопроекте ЕС, и выявили значительные различия в их соответствии, причем ни одна модель не соответствует всем критериям.
Исследование показывает пропасть между ожиданиями Закона об искусственном интеллекте и текущими усилиями по управлению среди ведущих разработчиков ИИ.
Чтобы соответствовать требованиям закона, разработчики должны значительно повысить уровень прозрачности и улучшить стратегии снижения рисков, которые в некоторых случаях практически полностью отсутствуют.
Как проводилось исследование
Авторы провели подробное исследование Закона об искусственном интеллекте, выделив 22 требования.
Из них они отобрали 12, которые можно полноценно оценить с помощью публичной информации. Затем они создали 5-балльную рубрику для каждого из этих 12 требований.
Модель искусственного интеллекта с открытым исходным кодом BLOOM, созданная компанией Hugging Face, стала самой высокорейтинговой моделью, набрав 36 из 48 возможных баллов.
Напротив, поддерживаемая Google компания Anthropic и немецкая компания Aleph Alpha, занимающаяся разработкой искусственного интеллекта, показали значительно худшие результаты, набрав 7 и 5 баллов соответственно. ChatGPT оказался в середине группы с результатом 25/48.
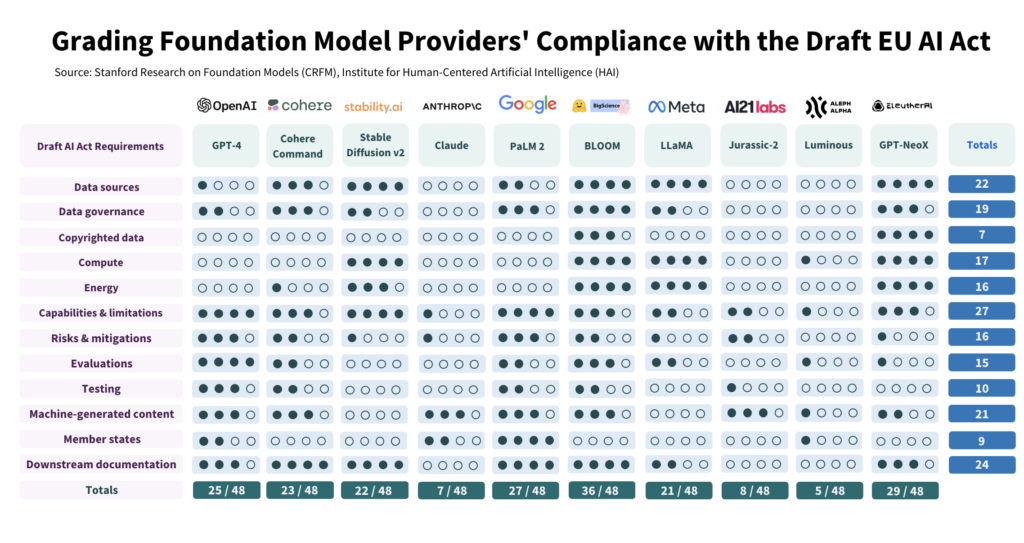
Четыре основные области несоответствия - это данные, защищенные авторским правом, энергия, снижение рисков и оценка/тестирование.
Один из авторов, Кевин Клайман, научный сотрудник Стэнфордского центра исследований моделей фундаментов, отметил, что большинство разработчиков не раскрывают свои стратегии снижения рисков, что может стать решающим фактором. Клайман сказал: "Поставщики часто не раскрывают эффективность своих мер по снижению рисков, что означает, что мы не можем сказать, насколько рискованными являются некоторые модели фундаментов".
Кроме того, существует большой разброс в учебных данных, используемых для обучения моделей. ЕС потребует от разработчиков ИИ быть более прозрачными в отношении источников данных, чего не делают 4/10 разработчиков. ChatGPT набрал только 1 балл в этой области.
Открытый исходный код в сравнении с проприетарными моделями
Отчет также выявил четкую дихотомию в соблюдении требований в зависимости от того, является ли модель с открытым исходным кодом или проприетарной.
Модели с открытым исходным кодом получили высокие оценки по раскрытию информации о ресурсах и требованиям к данным, но их риски в основном не документированы.
Собственные модели являются противоположностью - они тщательно протестированы и документированы, имеют надежные стратегии снижения рисков, но непрозрачны в отношении данных и технологических показателей.
Или, если говорить более тонко, у разработчиков открытого кода не так много конкурентных секретов, которые нужно защищать, но их продукты изначально более рискованные, поскольку их может использовать и модифицировать практически каждый.
И наоборот, частные разработчики, скорее всего, будут держать некоторые аспекты своих моделей под замком, но смогут продемонстрировать безопасность и снижение рисков. Даже Microsoft, основной инвестор OpenAI, не полностью понять, как работают модели OpenAI.
Что рекомендует исследование?
Авторы исследования признают, что разрыв между ожиданиями ЕС и реальностью вызывает тревогу, и выдвигают ряд рекомендаций для политиков и разработчиков моделей.
Исследование рекомендует политикам ЕС:
- Уточнить и конкретизировать параметры Закона ЕС об искусственном интеллекте: Исследователи утверждают, что технический язык и параметры Закона об искусственном интеллекте недостаточно определены.
- Содействие прозрачности и подотчетности: Исследователи утверждают, что самые строгие правила должны быть направлены на самых крупных и доминирующих разработчиков, что должно привести к более эффективному правоприменению.
- Обеспечить достаточные ресурсы для правоприменения: Для эффективного применения Закона ЕС об искусственном интеллекте необходимо предоставить правоприменительным органам технические ресурсы и талантливых специалистов.
Исследование рекомендует мировым политикам:
- Приоритет прозрачности: Исследователи подчеркивают, что прозрачность имеет решающее значение и должна быть основным направлением политических усилий. Они утверждают, что уроки регулирования социальных сетей показывают пагубные последствия недостаточной прозрачности, которые не должны повториться в контексте ИИ.
- Уточните вопросы авторского права: Границы авторского права на обучающие данные ИИ и результаты работы ИИ являются предметом жарких споров. Учитывая низкий уровень соблюдения авторских прав при раскрытии данных обучения, исследователи утверждают, что в правовых инструкциях должно быть указано, как авторское право взаимодействует с процедурами обучения и результатами работы генеративных моделей. Это включает в себя определение условий, на которых авторские права или лицензии должны соблюдаться во время обучения, и определение того, как контент, созданный машиной, может нарушать авторские права.
Исследование дает рекомендации разработчикам моделей фундаментов:
- Стремитесь к постоянному совершенствованию: Поставщики должны постоянно стремиться к улучшению своего соответствия. Крупные провайдеры, такие как OpenAI, должны подавать пример и распространять ресурсы для последующих клиентов, получающих доступ к их моделям через API.
- Выступайте за отраслевые стандарты: Поставщики моделей должны внести свой вклад в разработку отраслевых стандартов, что может привести к созданию более прозрачной и подотчетной экосистемы ИИ.
Хотя в стандартах риска и мониторинга, установленных ведущими разработчиками вроде OpenAI, есть и положительные моменты, недостатки в таких областях, как авторское право, далеки от идеала.
Что касается применения регулирования к ИИ как всеохватывающей категории - это может оказаться очень сложным. - поскольку коммерческие модели и модели с открытым исходным кодом структурно отличаются друг от друга и их трудно объединить.